Grundlagen und Begriffe

KI im Finanzmanagement

Künstliche Intelligenz kann Finanzdaten sortieren, zusammenfassen und auf Auffälligkeiten prüfen. Manche Systeme arbeiten mit festen Regeln, andere erkennen statistische Muster. Häufig werden beide Ansätze kombiniert. Ob ein Ergebnis brauchbar ist, hängt von den Ausgangsdaten, der Modellversion und der konkreten Aufgabe ab. Es bleibt eine technische Auswertung und ist keine persönliche Finanzentscheidung. Wer ein Ergebnis später prüfen möchte, sollte deshalb wissen, welche Methode und welche Daten verwendet wurden.

Von der Datenquelle zur Ausgabe

Am Anfang steht immer die Frage: Woher kommen die Daten? Tabellen, Belege und Berichte verwenden oft unterschiedliche Namen, Einheiten oder Zeiträume. Vor der Auswertung müssen diese Angaben vereinheitlicht und fehlende Pflichtfelder erkannt werden. Danach wendet das System ein Modell oder ein Regelwerk an. Das Ergebnis kann eine Liste, eine Kategorie, eine Zusammenfassung oder ein Prüfhinweis sein. Quelle, Datenstand und Methode sollten dabei erhalten bleiben, damit ein Mensch das Ergebnis nachvollziehen kann.

Drei Ebenen der Datenverarbeitung

Erfassung

Bei der Erfassung wird festgehalten, welche Felder vorhanden sind, welches Format sie haben und aus welcher Quelle sie stammen. Persönliche Angaben gehören nur dann dazu, wenn sie für die Aufgabe wirklich nötig sind. Uneinheitliche Werte müssen geklärt werden, bevor sie sinnvoll ausgewertet werden können.

Analyse

In der Analyse werden Merkmale nach festgelegten Regeln oder Modellparametern ausgewertet. Daraus können Kategorien, Wahrscheinlichkeiten oder zusammengefasste Werte entstehen. Die gewählte Methode entscheidet, welche Beziehungen im Datensatz überhaupt sichtbar werden.

Kontrolle

Bei der Kontrolle wird das Ergebnis mit Quelle, Zeitraum und Definition verglichen. Fehlende Angaben oder Abweichungen werden markiert. Sobald ein Fall mehrdeutig ist oder Hintergrundwissen verlangt, bleibt eine menschliche Prüfung notwendig. Dabei sollte auch festgehalten werden, wer die Prüfung vorgenommen hat und auf welche Fassung der Daten sie sich bezog. So bleibt eine spätere Änderung nachvollziehbar.

MODELLKONTEXT

Daten, Annahmen und dokumentierte Grenzen

Sachliche Einordnung

Ein KI-Modell sieht nur die Merkmale, die in seinen Eingabedaten vorhanden sind. Fehlende Datensätze, neue Ereignisse oder unklare Bezeichnungen kann es nicht zuverlässig ergänzen. Deshalb sollten Modellversion, Erstellungszeitpunkt und bekannte Einschränkungen zusammen mit dem Ergebnis gespeichert werden. Auch scheinbar einfache Felder brauchen Kontext: „Betrag“ kann zum Beispiel einen Brutto-, Netto- oder Teilwert meinen. Ohne Definition, Einheit und Zeitraum kann eine Rechnung korrekt und ihre Aussage trotzdem unklar sein. Eine statistische Zuordnung zeigt daher eine Modellberechnung, keine Gewissheit über einen einzelnen Fall.
Formen der Ausgabe

Typische Informationsdarstellungen

Strukturierte Tabellen

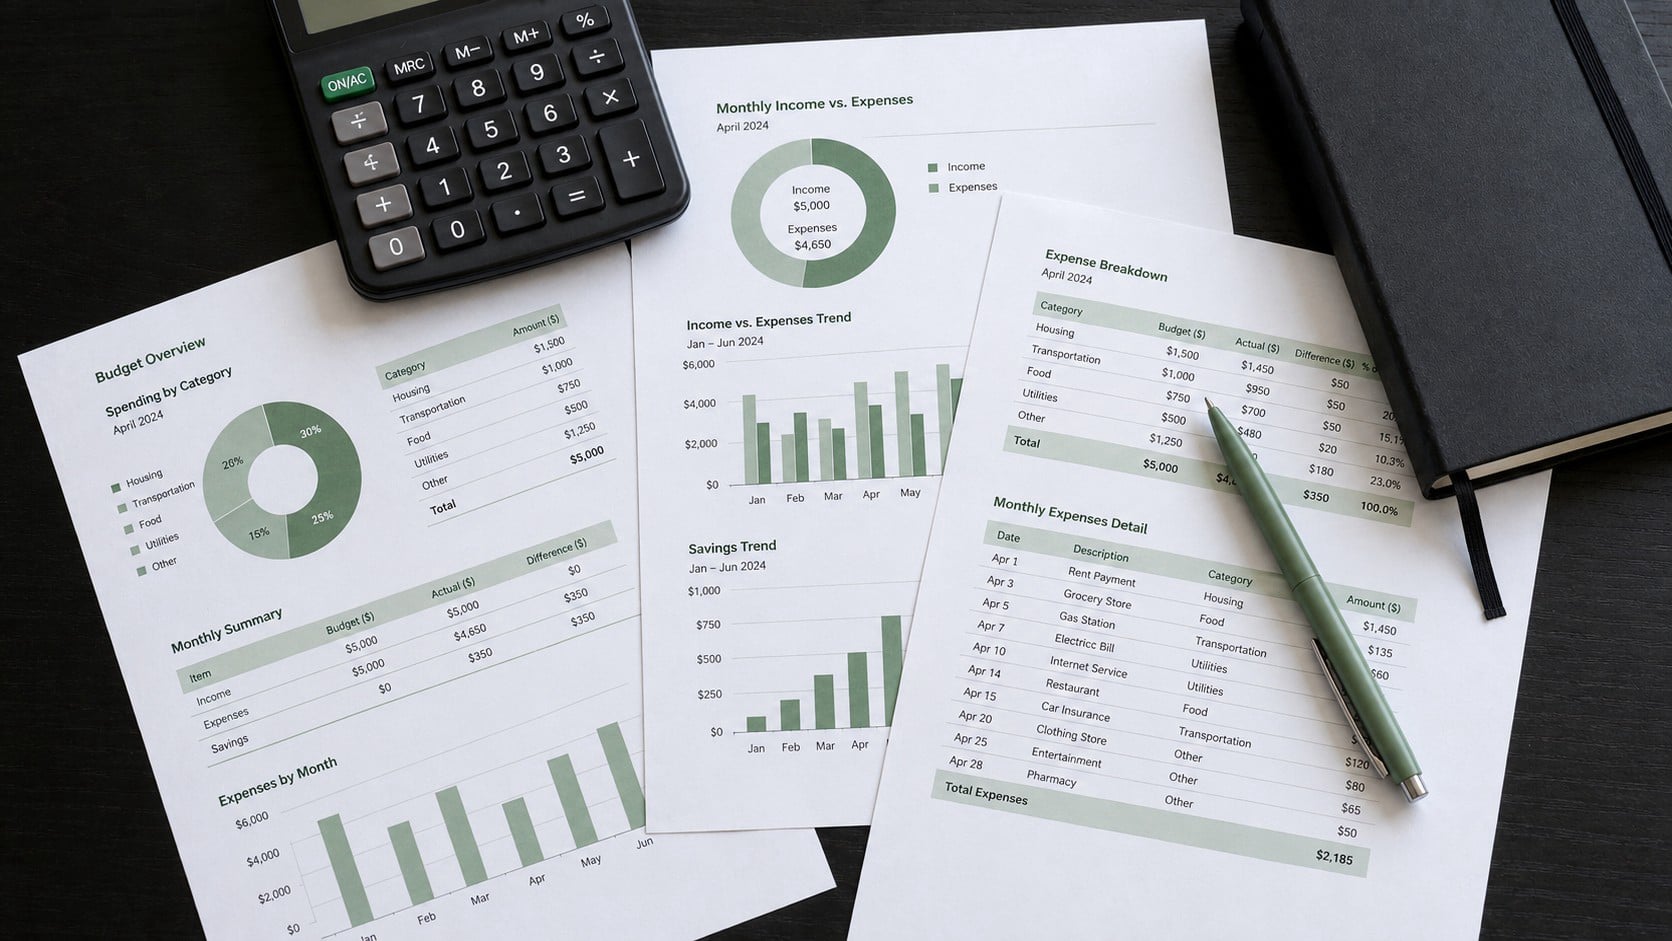
Tabellen machen viele Werte schnell vergleichbar. Dafür müssen Spaltennamen, Einheiten und Zeiträume eindeutig sein. Fehlende Werte brauchen eine klare Kennzeichnung, damit sie nicht mit der Zahl null verwechselt werden. Angaben zu Quelle, Zeitpunkt und Bearbeitungsstand zeigen außerdem, ob ein Wert direkt übernommen oder später berechnet wurde.

Kategorien und Merkmale

Kategorien fassen Einträge mit gemeinsamen Merkmalen zusammen. Damit sie verständlich bleiben, braucht jede Kategorie eine klare Definition. Auch Ausnahmen und Abgrenzungen sollten dokumentiert werden. Eine solche Einordnung schafft Ordnung in den Daten, ist aber keine persönliche Bewertung oder fachliche Empfehlung.

Zusammenfassende Berichte

Berichte verbinden ausgewählte Zahlen mit Hinweisen zu Quelle und Methode. Zusammengefasste Werte können wichtige Einzelheiten verdecken. Deshalb sollten Umfang, Zeitraum und Berechnungsweise direkt beim Bericht stehen.